Rimani aggiornato con WebMasterPoint
Un Dell R720 del 2010 riesce a eseguire GLM 5.3, dimostrando che lIA pu funzionare anche su hardware datato: tra quattro token al secondo, consumi, costi e confronto con le GPU.
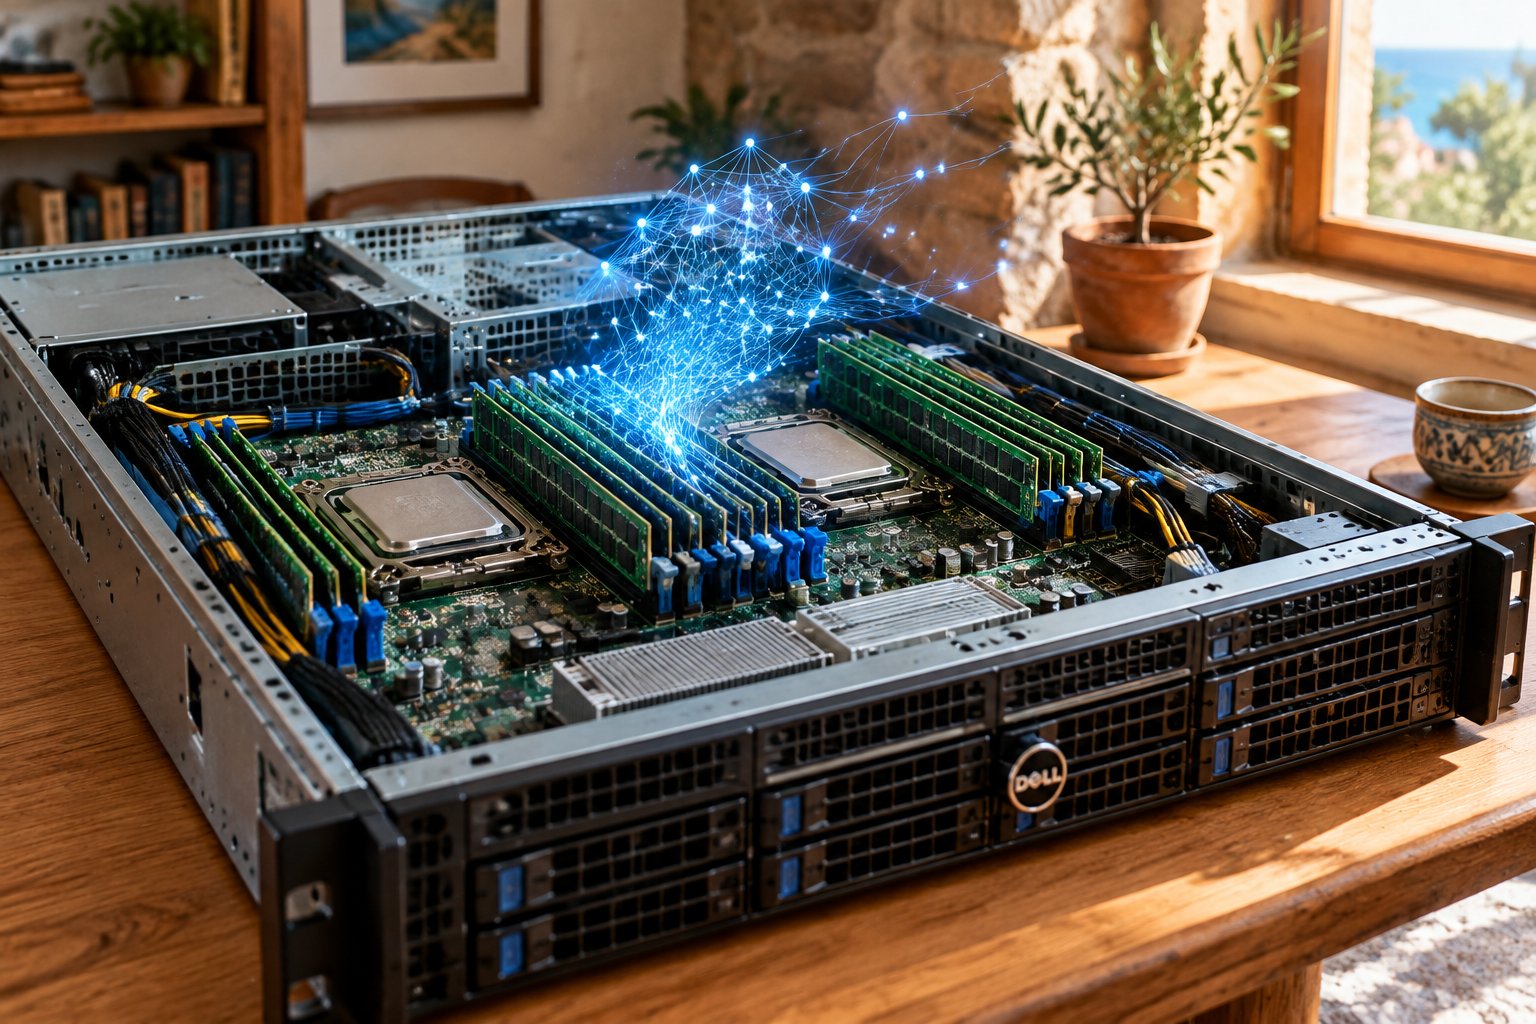
Un Dell PowerEdge R720 del 2012 ha eseguito GLM 5.3 Flash senza alcuna GPU, usando due processori Xeon e 348 GB di memoria DDR3. Nel test pubblicato da MattMo il 20 settembre 2026, il server ha raggiunto una velocit massima di circa 4 token al secondo. abbastanza per mostrare che il modello pu funzionare anche su hardware usato; non abbastanza, per, per trasformare quella macchina in una workstation adatta alla conversazione in tempo reale.
La prova include anche Qwen 3.8 Flash e Qwen 3.8 27B. Il dato pi significativo, quindi, non la velocit raggiunta, bens la possibilit di caricare modelli molto grandi nella memoria di sistema di un server progettato per i data center di oltre dieci anni fa.
Il Dell R720 che esegue lintelligenza artificiale
Il PowerEdge R720 un server rack a due socket compatibile con le famiglie Intel Xeon E5-2600 ed E5-2600 v2. La configurazione usata nel test monta due Xeon, per un totale di 20 thread, 348 GB di RAM DDR3 ECC e nessuna scheda grafica dedicata.
GLM 5.3 Flash un modello multimodale Mixture of Experts da circa 320 miliardi di parametri complessivi, dei quali 18 miliardi sono attivi per token. La documentazione tecnica riporta 45 livelli, un instradamento tra 288 esperti e una finestra di contesto configurata fino a 1.048.576 token (2026).
Questa architettura limita il lavoro attivo richiesto per ciascun token. Non evita, per, di dover conservare una grande quantit di pesi nella memoria. Nel Dell R720 il modello viene quindi tenuto nella RAM di sistema, non nella VRAM. I 348 GB disponibili bastano a contenere il carico; a rallentare linferenza soprattutto la capacit di calcolo dei due Xeon.
I processori della macchina, inoltre, non includono alcune istruzioni pi recenti che avrebbero potuto accelerare linferenza. Il risultato un sistema capace di ospitare il modello, ma privo dellaccelerazione necessaria per generare testo a una velocit paragonabile a quella di una GPU moderna.
| Elemento | Configurazione del test |
| Server | Dell PowerEdge R720 (2012) |
| Processori | Due Intel Xeon, 20 thread complessivi (2026) |
| Memoria | 348 GB DDR3 ECC (2026) |
| Acceleratore | Nessuna GPU (2026) |
| Prestazioni | Circa 4 token al secondo (2026) |
| Prezzo stimato | Circa 600 dollari sul mercato usato (2026) |
Quattro token al secondo: quando bastano
Quattro token al secondo sono pochi per una chat. Una risposta di 120 token richiede, in teoria, circa 30 secondi, senza contare il tempo impiegato per elaborare il prompt. Lattesa si allunga ancora nelle attivit di programmazione assistita o nelle applicazioni ad agenti, dove il modello deve produrre molti passaggi consecutivi.
Per alcuni lavori, invece, la latenza pesa meno. Il server pu essere utilizzato per:
- analisi documentale eseguita in coda;
- classificazione di grandi archivi durante la notte;
- generazione di riassunti e report non urgenti;
- test locali di modelli, software e pipeline;
- elaborazioni private che non devono uscire dalla rete aziendale.
Il vantaggio economico riguarda soprattutto chi possiede gi un server simile. In quel caso, la spesa aggiuntiva pu fermarsi ai dischi, alla configurazione del software e allenergia elettrica. Chi deve acquistare oggi un R720 con lobiettivo specifico di usarlo per lintelligenza artificiale deve invece valutare con attenzione costi e limiti.
Prezzo, consumi e confronto con le GPU
La stima di 600 dollari (2026) riguarda una configurazione dotata di molta memoria. Nel mercato dellusato sono comparsi R720xd con circa 104 GB di RAM a circa 300 dollari (2026), ma una quantit simile non sarebbe sufficiente per ripetere il test. Il prezzo effettivo cambia in base ai processori installati, ai moduli DIMM, ai dischi, al controller RAID e agli alimentatori inclusi.
Resta poi il tema dei consumi. Il test originale non pubblica una misurazione elettrica completa del R720, perci non corretto attribuire al server un valore preciso. Come riferimento separato, un sistema desktop con Intel Core i7-4790, impiegato per confronti con modelli ternari pi piccoli, stato indicato a circa 100 watt complessivi (2026) e a 7-8 token al secondo. Non si tratta, per, di un confronto diretto con GLM 5.3 Flash.
A 100 watt continui, il consumo teorico raggiunge 876 kWh lanno (2026), prima di considerare le perdite e i periodi di inattivit. Un server rack con due Xeon, memoria ECC e ventole ad alta portata pu superare quella soglia. In questo caso la bolletta elettrica rischia di ridurre, o anche di annullare, una parte del risparmio ottenuto comprando hardware usato.
Quando servono risposte rapide o pi richieste simultanee, le GPU restano la scelta migliore. La versione FP8 di GLM 5.3 Flash richiede circa 306 GiB di memoria per i pesi (2026), una capacit che normalmente porta a usare pi acceleratori oppure una piattaforma professionale.
Il Dell evita il costo iniziale di quelle GPU, ma lo fa pagando con una latenza elevata. Non sostituisce quindi una macchina accelerata. Pu avere senso, invece, come sistema locale e autonomo per laboratori domestici, sperimentazione e processi batch, soprattutto quando gi disponibile.
A quattro token al secondo, il punto da valutare non pi se il modello riesca a funzionare. La questione se il lavoro da svolgere possa aspettare.